
Giám sát thời gian thực tài nguyên cải thiện hiệu suất thế nào?
Mục lục
- Biến mức tiêu hao thành tín hiệu có thể hành động
- Phát hiện tiêu hao bất thường trước khi thành lãng phí kéo dài
- Điều chỉnh phân bổ theo nhu cầu thực thay vì công suất dự phòng cố định
- Đo hiệu suất bằng đầu ra trên mỗi đơn vị tài nguyên
- Chu kỳ lấy mẫu và ngưỡng cảnh báo quyết định chất lượng giám sát
- Hiệu quả cao nhất đến từ vòng phản hồi khép kín
Giám sát thời gian thực giúp nhìn thấy mức sử dụng, độ bão hòa và biến động tài nguyên ngay khi chúng phát sinh, từ đó phát hiện tiêu hao bất thường, điều chỉnh phân bổ và kiểm chứng hiệu quả bằng dữ liệu thay vì chờ báo cáo tổng hợp.
Hiệu suất tài nguyên không đơn giản là sử dụng ít CPU, bộ nhớ, băng thông, điện năng hay công suất thiết bị hơn. Một hệ thống chỉ thực sự hiệu quả khi lượng tài nguyên tiêu thụ tương xứng với khối lượng công việc và mức dịch vụ tạo ra. Vì vậy, vấn đề quan trọng là biết tài nguyên đang được dùng ở đâu, vào thời điểm nào, với tải nào và mức tiêu hao đó có bình thường hay không.
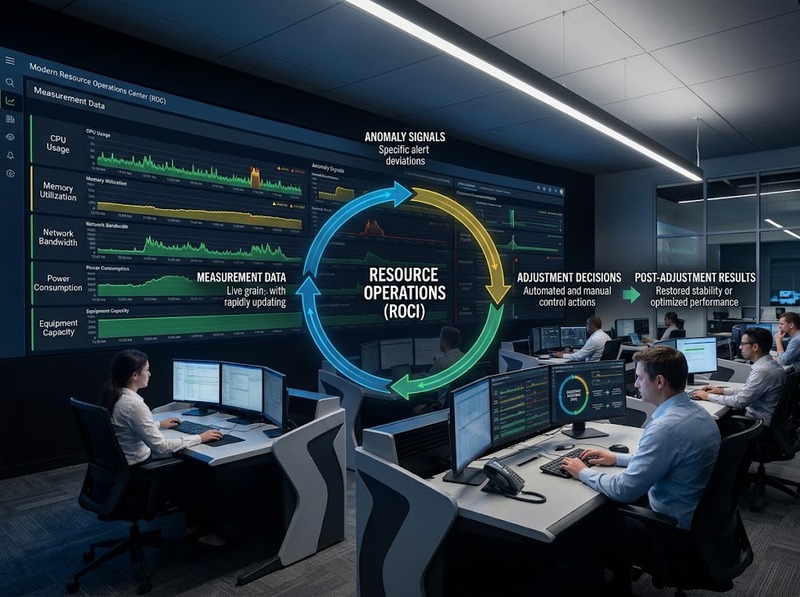
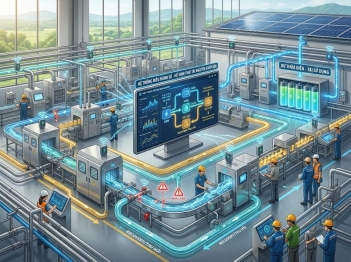
Giám sát thời gian thực tạo ra chuỗi phản hồi ngắn hơn giữa đo lường → phát hiện lệch chuẩn → xác định nguyên nhân → điều chỉnh → kiểm chứng. Giá trị của công nghệ không nằm ở việc có nhiều biểu đồ hơn, mà ở khả năng phát hiện một thay đổi khi nó vẫn còn đủ sớm để can thiệp.
“Thời gian thực” cũng không nhất thiết đồng nghĩa với đo liên tục từng mili giây. Chu kỳ lấy mẫu phải phù hợp với tốc độ biến động của tài nguyên và tốc độ cần phản ứng. Nếu sự cố có thể hình thành trong vài phút nhưng hệ thống chỉ tổng hợp dữ liệu mỗi giờ, phần lớn diễn biến quan trọng sẽ bị che khuất dù báo cáo cuối ngày vẫn chính xác về mặt tổng lượng.
Biến mức tiêu hao thành tín hiệu có thể hành động
Các báo cáo tổng hợp thường cho biết một hệ thống đã tiêu thụ bao nhiêu tài nguyên trong một khoảng thời gian. Giám sát thời gian thực bổ sung thông tin quan trọng hơn: tiêu thụ diễn ra như thế nào trong suốt khoảng thời gian đó.
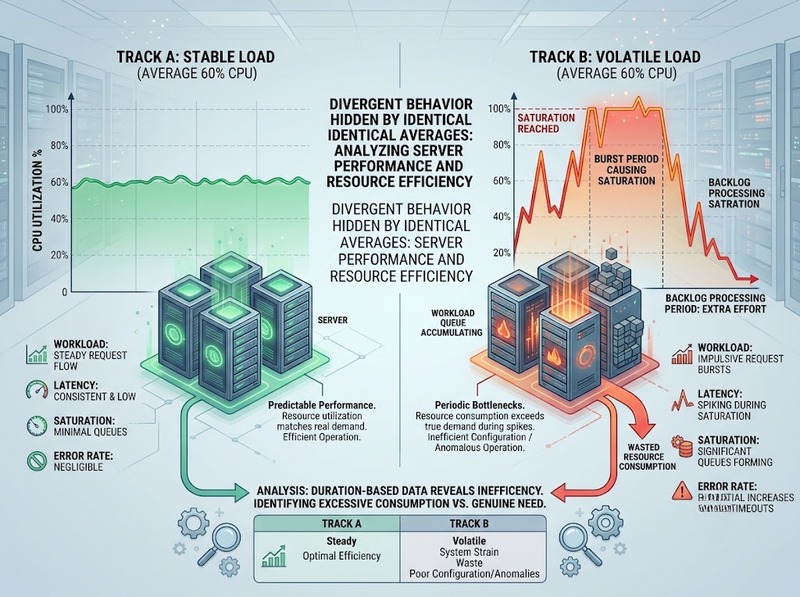
Hai hệ thống có thể cùng đạt mức sử dụng CPU trung bình 60%, nhưng trạng thái vận hành hoàn toàn khác nhau. Một hệ thống duy trì quanh 60% khá ổn định; hệ thống còn lại có thể chạy 40% trong 10 phút rồi bão hòa 100% trong 5 phút. Trung bình của trường hợp thứ hai vẫn là 60%, nhưng khoảng bão hòa 5 phút có thể làm hàng đợi tăng, thời gian phản hồi kéo dài và buộc hệ thống sử dụng thêm tài nguyên để xử lý phần việc tồn đọng.
Vì vậy, chỉ số trung bình cần được đặt cạnh các tín hiệu khác như mức sử dụng tức thời, độ bão hòa, lưu lượng công việc, thời gian đáp ứng và tỷ lệ lỗi. Trong vận hành hệ thống số, cách tiếp cận này tương đồng với mô hình “golden signals” của Site Reliability Engineering: không chỉ quan sát tài nguyên đang dùng bao nhiêu mà còn xem nhu cầu, độ trễ, lỗi và mức bão hòa thay đổi ra sao.
Khi dữ liệu được gắn với đúng thời điểm và đúng tải công việc, đội vận hành có thể phân biệt ba tình huống vốn dễ bị trộn lẫn trong báo cáo tổng hợp: tiêu hao tăng vì nhu cầu thực sự tăng, tiêu hao tăng vì cấu hình hoặc quy trình kém hiệu quả, và tiêu hao tăng do một bất thường cần xử lý.
Phát hiện tiêu hao bất thường trước khi thành lãng phí kéo dài
Một mức sử dụng cao chưa chắc là bất thường. CPU đạt 90% khi lưu lượng tăng mạnh có thể là dấu hiệu tài nguyên đang được khai thác tốt; CPU duy trì 50% vào thời điểm gần như không có tải lại có thể đáng điều tra hơn. Bởi vậy, phát hiện bất thường cần dựa vào ngữ cảnh và đường cơ sở, không chỉ dựa vào một ngưỡng cố định.
Đường cơ sở có thể mô tả mức tiêu thụ thường thấy theo thời gian trong ngày, ngày trong tuần, khối lượng giao dịch hoặc sản lượng. Hệ thống sau đó theo dõi độ lệch so với mẫu này. Một máy chủ thường sử dụng 20–30% CPU vào ban đêm nhưng đột ngột duy trì 65% dù lưu lượng không thay đổi tạo ra tín hiệu khác hẳn việc CPU tăng lên 65% trong giờ cao điểm.
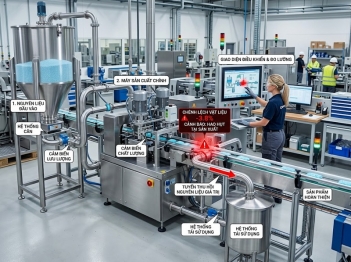
Tốc độ thay đổi cũng quan trọng. Bộ nhớ tăng từ 45% lên 48% chưa đáng lo nếu sau đó ổn định, nhưng mức tăng đều vài phần trăm mỗi giờ có thể cho thấy rò rỉ bộ nhớ. Điện năng trên mỗi đơn vị sản lượng tăng liên tục trong khi sản lượng giữ nguyên có thể phản ánh thiết bị hoạt động ngoài vùng tối ưu. Băng thông tăng nhưng số yêu cầu không đổi có thể chỉ ra truyền dữ liệu dư thừa.
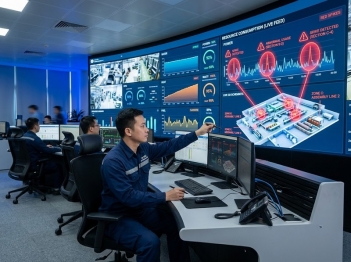
Giám sát gần thời gian thực rút ngắn “thời gian tồn tại không được phát hiện” của những hiện tượng này. Nếu bất thường phát sinh lúc 09:05 nhưng chỉ được nhận ra khi báo cáo ngày được tổng hợp vào cuối ca, phần tiêu hao dư đã kéo dài nhiều giờ. Khi tín hiệu được phát hiện sớm, đội vận hành có thể kiểm tra nguyên nhân khi trạng thái gây ra nó vẫn còn tồn tại và dữ liệu liên quan chưa bị hòa vào mức trung bình dài hạn.
Điều đó không có nghĩa mọi độ lệch đều phải phát cảnh báo. Cảnh báo chỉ có giá trị khi độ lệch đủ lớn, đủ lâu hoặc liên quan đến một chỉ số khác cho thấy rủi ro thực sự. Nếu mọi dao động nhỏ đều tạo thông báo, nhiễu cảnh báo sẽ làm giảm khả năng phản ứng với sự kiện quan trọng.
Điều chỉnh phân bổ theo nhu cầu thực thay vì công suất dự phòng cố định
Khi chỉ có dữ liệu lịch sử thô, tổ chức thường phải giữ một khoảng công suất dự phòng lớn để tránh thiếu tài nguyên trong giờ cao điểm. Giám sát thời gian thực cho phép thay thế một phần cách tiếp cận này bằng phân bổ động dựa trên nhu cầu quan sát được.
Trong hạ tầng số, dữ liệu về CPU, bộ nhớ, hàng đợi và lưu lượng có thể kích hoạt tăng hoặc giảm số phiên bản xử lý. Khi tải tăng, tài nguyên được bổ sung; khi tải giảm, phần công suất không còn cần thiết được thu hồi. Giá trị không phải là luôn chạy ở tỷ lệ sử dụng cao nhất, mà là giảm khoảng cách giữa tài nguyên được cấp và tài nguyên thực sự cần cho mức dịch vụ mục tiêu.
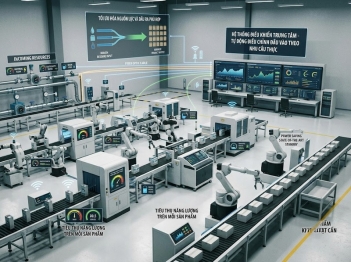
Cùng nguyên lý đó có thể áp dụng cho năng lượng và công suất thiết bị. Nếu hệ thống nhìn thấy một nhóm thiết bị vẫn tiêu thụ đáng kể trong thời gian không tạo sản lượng, có thể kiểm tra chế độ chờ, lịch vận hành hoặc cách chia tải. Nếu hai thiết bị cùng đáp ứng một nhu cầu nhưng một thiết bị tiêu thụ nhiều tài nguyên hơn cho cùng đầu ra, dữ liệu thời gian thực tạo cơ sở để thay đổi thứ tự vận hành.
Tuy nhiên, tối ưu không đồng nghĩa với cắt hết phần dự phòng. Một hệ thống chạy sát giới hạn liên tục có thể rất “đẹp” về tỷ lệ sử dụng nhưng dễ suy giảm hiệu năng khi tải tăng đột ngột. Với tài nguyên có thời gian cấp bổ sung dài, cần duy trì headroom phù hợp. Khi tài nguyên có thể mở rộng nhanh, phần dự phòng tĩnh có thể nhỏ hơn.
Do đó, quyết định phân bổ nên dựa đồng thời vào mức sử dụng, độ bão hòa, tốc độ tăng tải và thời gian cần để bổ sung tài nguyên. Chỉ nhìn vào utilization có thể dẫn đến cắt giảm quá mức.
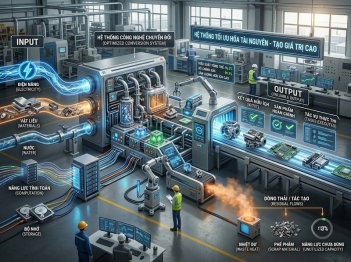
Đo hiệu suất bằng đầu ra trên mỗi đơn vị tài nguyên
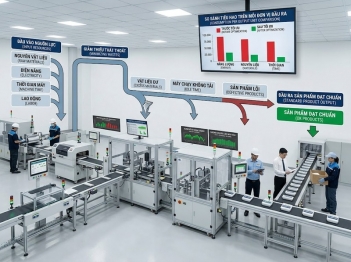
Giảm tổng mức tiêu thụ chưa đủ để chứng minh hiệu suất đã tốt hơn. Nếu điện năng giảm 10% nhưng sản lượng giảm 20%, hiệu quả thực tế có thể xấu đi. Tương tự, giảm số máy chủ nhưng làm thời gian phản hồi tăng mạnh không phải là tối ưu nếu chất lượng dịch vụ không còn đạt yêu cầu.
Các chỉ số nên liên kết tài nguyên với đầu ra, chẳng hạn:
· CPU-giờ trên mỗi nghìn giao dịch
· GB bộ nhớ trên mỗi đơn vị workload
· kWh trên mỗi đơn vị sản phẩm
· Chi phí hạ tầng trên mỗi giao dịch thành công
· Thời gian nhàn rỗi trên tổng thời gian sẵn sàng của thiết bị
· Băng thông trên mỗi đơn vị dữ liệu hữu ích
Với năng lượng, tư duy này phù hợp với nguyên tắc quản lý hiệu suất năng lượng của ISO 50001: theo dõi và đo lường phải hỗ trợ đánh giá kết quả và cải tiến, thay vì chỉ ghi nhận tổng lượng tiêu thụ.
Giám sát thời gian thực làm cho những tỷ lệ trên hữu ích hơn vì có thể ghép mức tiêu hao với workload tại cùng thời điểm. Ví dụ, điện năng tăng 15% trong một giờ không thể tự nó chứng minh có lãng phí. Nếu sản lượng trong giờ đó tăng 25%, cường độ năng lượng trên mỗi đơn vị thực tế đã giảm khoảng 8%. Ngược lại, điện năng tăng 15% trong khi sản lượng không thay đổi là tín hiệu cần tìm nguyên nhân.
Dữ liệu trước và sau một thay đổi cũng tạo ra vòng kiểm chứng. Nếu giảm mức tài nguyên cấp cho một dịch vụ, cần kiểm tra không chỉ chi phí giảm bao nhiêu mà còn xem độ trễ, tỷ lệ lỗi và độ bão hòa có thay đổi không. Một điều chỉnh chỉ nên được coi là cải thiện khi hiệu suất tài nguyên tăng mà các ràng buộc vận hành quan trọng vẫn được giữ.
Chu kỳ lấy mẫu và ngưỡng cảnh báo quyết định chất lượng giám sát
Thu thập dữ liệu thường xuyên hơn không tự động tạo ra quyết định tốt hơn. Khoảng lấy mẫu phải đủ nhỏ để nhìn thấy hiện tượng cần kiểm soát nhưng không nhỏ đến mức tạo khối lượng dữ liệu và nhiễu vượt quá giá trị thu được.
Một sự kiện kéo dài 3 phút có thể biến mất hoàn toàn trong báo cáo trung bình theo giờ. Nhưng nếu hiện tượng cần quản lý chỉ thay đổi theo chu kỳ nhiều giờ, thu thập mỗi giây có thể không bổ sung thông tin hữu ích. Vì vậy, độ phân giải dữ liệu nên xuất phát từ câu hỏi vận hành: một bất thường có thể hình thành nhanh đến mức nào và đội vận hành cần phản ứng trong bao lâu?
Ngưỡng cũng cần được thiết kế tương tự. Quy tắc như “CPU trên 80% là xấu” thiếu ngữ cảnh vì một workload có thể hoạt động ổn định ở mức này, trong khi workload khác bắt đầu tạo hàng đợi từ mức thấp hơn. Ngưỡng hiệu quả thường kết hợp nhiều yếu tố: độ lệch khỏi baseline, thời gian duy trì, độ bão hòa, ảnh hưởng đến chất lượng dịch vụ và trạng thái của các tài nguyên liên quan.
Dữ liệu cũng phải được chuẩn hóa đủ để so sánh. Nếu một hệ thống đo tổng điện năng còn hệ thống khác đo điện năng trên mỗi đơn vị đầu ra, việc đặt hai giá trị cạnh nhau có thể tạo kết luận sai. Tương tự, CPU trung bình của cả cụm có thể che một máy riêng lẻ đã bão hòa. Phạm vi đo phải khớp với phạm vi quyết định.
Cuối cùng, giám sát chỉ phản ánh những gì cảm biến và telemetry quan sát được. Dữ liệu trễ, mất mẫu, đồng hồ không đồng bộ hoặc cấu hình đo sai đều có thể tạo “bất thường” giả. Trước khi tự động điều chỉnh tài nguyên dựa trên tín hiệu, cần bảo đảm chất lượng dữ liệu đủ cao và có cơ chế tránh phản ứng với một điểm đo đơn lẻ.
Hiệu quả cao nhất đến từ vòng phản hồi khép kín
Dashboard cho biết trạng thái; vòng phản hồi mới tạo ra cải thiện. Một quy trình giám sát có giá trị cần nối dữ liệu với hành động cụ thể.
Trước hết, tổ chức xác định chỉ số phản ánh mức sử dụng và hiệu suất của từng loại tài nguyên. Sau đó xây baseline theo tải hoặc sản lượng, thay vì chỉ dựa trên một ngưỡng tuyệt đối. Khi hệ thống phát hiện độ lệch đáng kể, dữ liệu liên quan được đối chiếu để xác định liệu nguyên nhân đến từ nhu cầu tăng, cấu hình sai, tài nguyên bị kẹt, thiết bị xuống hiệu suất hay một thay đổi vận hành gần đây.
Hành động có thể là tự động hoặc do con người phê duyệt. Các thay đổi có tính thuận nghịch và rủi ro thấp, chẳng hạn tăng thêm phiên bản xử lý khi hàng đợi tăng, phù hợp với tự động hóa hơn. Những quyết định ảnh hưởng đến an toàn, chất lượng hoặc công suất dài hạn cần thêm điều kiện và quyền kiểm soát.
Sau thay đổi, hệ thống phải tiếp tục đo. Nếu tài nguyên tiêu thụ giảm nhưng workload, độ trễ hoặc chất lượng đầu ra xấu đi, điều chỉnh đó chưa đạt mục tiêu. Nếu mức tiêu hao trên mỗi đơn vị đầu ra giảm trong khi các ràng buộc vận hành vẫn ổn định, dữ liệu đã chứng minh được hiệu quả.
Đây là điểm khác biệt giữa “có hệ thống giám sát” và “dùng giám sát để tối ưu tài nguyên”. Công nghệ chỉ tạo lợi ích khi thời gian từ tín hiệu đến quyết định đủ ngắn, phép đo gắn đúng với đầu ra và mỗi điều chỉnh đều được kiểm chứng bằng dữ liệu sau can thiệp.
Giám sát thời gian thực cải thiện hiệu suất tài nguyên bằng cách làm rõ tài nguyên đang được tiêu thụ ở đâu, mức tiêu hao có tương xứng với tải hay không và khi nào cần điều chỉnh. Dữ liệu có độ phân giải phù hợp giúp phát hiện các đợt bão hòa, rò rỉ và tiêu hao ngoài baseline mà số liệu trung bình dễ che khuất; đồng thời cho phép phân bổ tài nguyên sát hơn với nhu cầu thực.
Hiệu quả chỉ bền vững khi giám sát được nối với một vòng phản hồi: đo mức sử dụng và đầu ra, nhận diện độ lệch, xác định nguyên nhân, điều chỉnh có kiểm soát rồi kiểm chứng lại bằng các KPI như tài nguyên trên mỗi đơn vị workload, mức bão hòa và chất lượng dịch vụ. Khi vòng này hoạt động tốt, tổ chức không chỉ nhìn thấy lãng phí sớm hơn mà còn biết một thay đổi có thực sự nâng hiệu suất hay chỉ chuyển vấn đề sang nơi khác.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm

Bài xem nhiều
