
Cách giám sát sự cố hệ thống quan trắc môi trường
Mục lục
- Những dấu hiệu cần theo dõi để phát hiện sự cố hệ thống quan trắc
- Phát hiện sự cố từ tín hiệu trạng thái của thiết bị
- Phát hiện sự cố thông qua hành vi bất thường của dữ liệu
- Giám sát sự cố từ đường truyền và hệ thống thu thập dữ liệu
- Thiết lập cảnh báo nhiều tầng thay vì chỉ dùng một ngưỡng
- Phân biệt sự cố thiết bị với biến động môi trường thật
- Quy trình xử lý khi hệ thống phát hiện dấu hiệu sự cố
- Các chỉ số nên dùng để đánh giá sức khỏe hệ thống
- Mô hình giám sát sự cố nên kết hợp rule-based và phát hiện bất thường
- Một hệ thống cảnh báo tốt phải chỉ ra được nguyên nhân gần nhất
Phát hiện sự cố hệ thống quan trắc môi trường cần đồng thời giám sát trạng thái thiết bị, tính hợp lệ của dữ liệu, đường truyền và các cảnh báo bất thường. Cách tiếp cận nhiều lớp giúp nhận biết sớm lỗi cảm biến, mất dữ liệu, trôi phép đo và gián đoạn truyền tin trước khi chúng làm sai lệch kết quả quan trắc.
Sự cố của hệ thống quan trắc môi trường không phải lúc nào cũng biểu hiện bằng việc thiết bị dừng hoàn toàn. Một cảm biến vẫn có thể trả số liệu nhưng số liệu bị trôi, một data logger vẫn hoạt động nhưng không truyền dữ liệu, hoặc đường truyền vẫn kết nối nhưng các bản ghi đến chậm và thiếu.
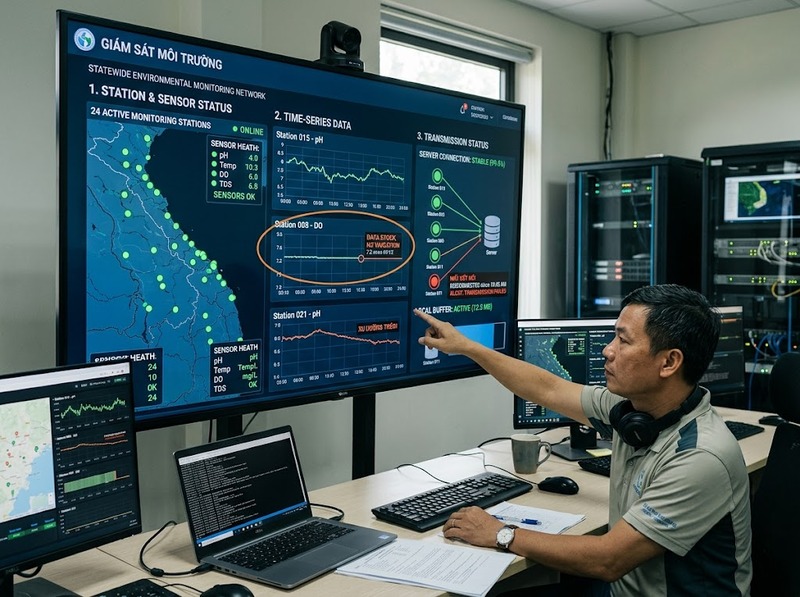
Vì vậy, muốn phát hiện sự cố sớm cần theo dõi đồng thời ba lớp: tín hiệu trạng thái của thiết bị, hành vi của dữ liệu và trạng thái truyền nhận/cảnh báo của toàn hệ thống. Khi ba lớp này được đối chiếu với nhau, người vận hành có thể phân biệt tốt hơn giữa biến động môi trường thực và lỗi kỹ thuật.
Những dấu hiệu cần theo dõi để phát hiện sự cố hệ thống quan trắc
Một hệ thống giám sát hiệu quả không nên chỉ đặt cảnh báo khi nồng độ hoặc thông số môi trường vượt ngưỡng. Cần theo dõi cả “sức khỏe” của chính hệ thống đo.
Các tín hiệu quan trọng gồm:
· Trạng thái hoạt động, lỗi và hiệu chuẩn của thiết bị đo
· Nguồn điện, bộ lưu điện và nhiệt độ bên trong tủ thiết bị
· Trạng thái bơm, lưu lượng lấy mẫu hoặc hệ thống điều hòa mẫu nếu có
· Giá trị đo có nằm trong dải hợp lý của thiết bị hay không
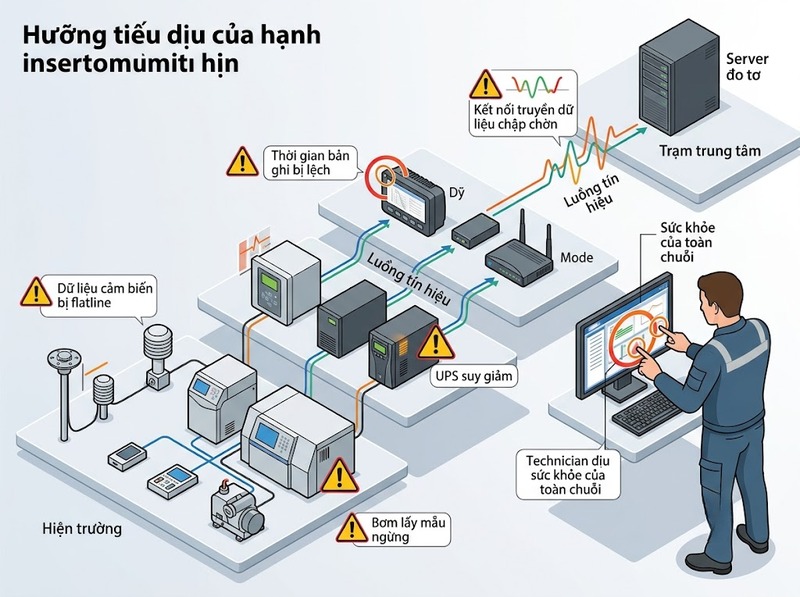
· Dữ liệu có bị mất, đứng yên, nhảy đột biến hoặc trôi dần hay không
· Thời gian giữa hai bản ghi có đúng chu kỳ dự kiến hay không
· Data logger có tiếp tục nhận dữ liệu từ thiết bị hay không
· Dữ liệu từ trạm có được truyền đầy đủ về máy chủ hay không
· Thời gian của thiết bị, data logger và máy chủ có đồng bộ hay không
· Cảnh báo có xuất hiện lặp lại hoặc kéo dài bất thường hay không
Đây cũng là lý do hệ thống quan trắc liên tục cần được nhìn nhận như một chuỗi gồm cảm biến → thiết bị phân tích → thu thập dữ liệu → lưu trữ → truyền dẫn → máy chủ → phần mềm giám sát, thay vì chỉ kiểm tra riêng cảm biến.
Phát hiện sự cố từ tín hiệu trạng thái của thiết bị
Tín hiệu trạng thái là nguồn phát hiện trực tiếp nhất đối với lỗi phần cứng hoặc điều kiện vận hành không bình thường.
Theo dõi trạng thái cảm biến và máy phân tích
Nếu thiết bị hỗ trợ các mã trạng thái như measuring, calibration, maintenance, fault, warning, chúng cần được thu thập cùng dữ liệu đo.
Ví dụ, một giá trị nồng độ xuất hiện trong thời gian thiết bị đang hiệu chuẩn không nên được diễn giải giống dữ liệu quan trắc bình thường. Tương tự, nếu máy phân tích báo lỗi nhưng phần mềm trung tâm vẫn chỉ hiển thị giá trị số mà bỏ qua cờ trạng thái, người vận hành có thể nhầm dữ liệu không hợp lệ thành kết quả thực tế.
Đối với hệ thống quan trắc phát thải liên tục, các chương trình QA/QC cũng coi việc theo dõi độ trôi hiệu chuẩn, bảo trì và hành động khắc phục là thành phần quan trọng để đánh giá chất lượng dữ liệu.
Theo dõi các thiết bị phụ trợ
Sự cố phép đo đôi khi không nằm ở cảm biến.
Với trạm lấy mẫu tự động, cần kiểm tra thêm:
· Bơm lấy mẫu có chạy hay không
· Lưu lượng mẫu có nằm trong vùng vận hành bình thường hay không
· Đường ống có tắc hoặc rò rỉ hay không
· Bộ lọc có gây giảm lưu lượng bất thường hay không
· Thiết bị làm mát, gia nhiệt hoặc điều hòa mẫu có hoạt động không
· Áp suất, nhiệt độ hoặc độ ẩm bên trong hệ thống có vượt giới hạn thiết kế không
Ví dụ, một máy phân tích khí vẫn hoạt động điện tử bình thường nhưng bơm lấy mẫu ngừng chạy. Khi đó giá trị hiển thị có thể tiếp tục tồn tại trong một thời gian nhưng không còn đại diện cho dòng khí đang cần quan trắc.
Theo dõi nguồn điện
Mất điện hoàn toàn thường dễ phát hiện. Nguy hiểm hơn là điện áp không ổn định, UPS suy giảm hoặc thiết bị khởi động lại liên tục.
Nên giám sát:
· Trạng thái nguồn chính
· Trạng thái UPS
· Dung lượng hoặc thời gian lưu điện còn lại
· Số lần thiết bị restart
· Thời gian khởi động lại
· Mất kết nối đồng thời của nhiều thiết bị
Nếu nhiều cảm biến mất tín hiệu cùng thời điểm, nguyên nhân có khả năng nằm ở nguồn, mạng hoặc data logger hơn là từng cảm biến độc lập.
Phát hiện sự cố thông qua hành vi bất thường của dữ liệu
Không phải sự cố nào cũng tạo mã lỗi. Vì vậy, giám sát dữ liệu đo là lớp phát hiện thứ hai.
Dữ liệu bị mất
Nếu chu kỳ dự kiến là một bản ghi sau mỗi khoảng thời gian cố định nhưng xuất hiện khoảng trống kéo dài, hệ thống cần sinh cảnh báo.
Cần phân biệt ít nhất ba trường hợp:
· Thiết bị không tạo dữ liệu
· Data logger không nhận được dữ liệu
· Data logger có dữ liệu nhưng máy chủ trung tâm không nhận được
Việc chỉ kiểm tra dữ liệu tại máy chủ không đủ để xác định nguyên nhân. Cùng một hiện tượng “mất dữ liệu” ở giao diện có thể xuất phát từ ba vị trí khác nhau.
Dữ liệu đứng yên bất thường
Một cảm biến bị treo có thể liên tục gửi cùng một giá trị.
Ví dụ:
7.21 → 7.21 → 7.21 → 7.21 → 7.21...
Một số thông số môi trường có thể ổn định tự nhiên, vì vậy không nên kết luận lỗi chỉ từ vài điểm giống nhau. Cảnh báo nên xét thêm:
· Khoảng thời gian giá trị không thay đổi
· Độ phân giải của cảm biến
· Mức biến thiên bình thường của thông số
· Trạng thái của các cảm biến liên quan
· Điều kiện vận hành của nguồn thải hoặc môi trường đo
“Flatline” kéo dài trong khi các biến liên quan vẫn thay đổi là dấu hiệu đáng nghi hơn nhiều so với một chuỗi giá trị ổn định ngắn.
Giá trị nhảy đột biến
Một điểm dữ liệu tăng hoặc giảm rất mạnh trong một chu kỳ có thể là biến động thực, nhưng cũng có thể do:
· Nhiễu điện
· Bọt khí
· Mất tiếp xúc cảm biến
· Thay đổi lưu lượng lấy mẫu
· Lỗi chuyển đổi tín hiệu
· Reset thiết bị
· Nhiễm bẩn đầu đo
Thay vì cảnh báo mọi điểm nhảy, hệ thống có thể kiểm tra tốc độ thay đổi, thời gian duy trì và tương quan với những thông số khác.
Một đỉnh chỉ tồn tại một mẫu rồi trở về ngay mức cũ thường cần được xem xét khác với một xu hướng tăng kéo dài qua nhiều mẫu.
Dữ liệu trôi dần
Drift khó nhận biết hơn lỗi đột ngột vì cảm biến vẫn tạo dữ liệu trông có vẻ hợp lý.
Dấu hiệu có thể gồm:
· Baseline dịch chuyển từ từ
· Sai lệch tăng dần sau mỗi lần kiểm tra chuẩn
· Một cảm biến ngày càng lệch so với cảm biến tham chiếu
· Quan hệ giữa hai thông số vốn ổn định bắt đầu thay đổi
Trong QA đối với CEMS, calibration drift được sử dụng trực tiếp để đánh giá liệu hệ thống còn duy trì được khả năng đo ổn định hay không; dữ liệu trong thời gian hệ thống mất kiểm soát về QA có thể không còn được xem như dữ liệu hợp lệ cho mục đích tuân thủ.
Giám sát sự cố từ đường truyền và hệ thống thu thập dữ liệu
Một trạm có thể đo hoàn toàn bình thường nhưng hệ thống giám sát trung tâm vẫn mất dữ liệu do lỗi truyền thông.
Vì vậy cần tách tình trạng phép đo khỏi tình trạng truyền dữ liệu.
Heartbeat của trạm
Trạm nên gửi một tín hiệu định kỳ chứng minh rằng:
· Data logger đang chạy
· Kết nối mạng còn tồn tại
· Dịch vụ truyền dữ liệu đang hoạt động
Nếu heartbeat mất nhưng dữ liệu cục bộ vẫn được lưu, đây chủ yếu là sự cố truyền dẫn chứ chưa phải lỗi phép đo.
Độ trễ dữ liệu
Không chỉ kiểm tra “có dữ liệu hay không”, hệ thống cần so sánh:
Thời gian máy chủ nhận dữ liệu – Thời gian dữ liệu được tạo
Độ trễ tăng đột ngột thường báo hiệu:
· Mạng yếu
· Server quá tải
· Hàng đợi truyền dữ liệu bị nghẽn
· Data logger đang phải truyền bù
· Sai lệch đồng hồ hệ thống
Trong các hệ thống giám sát tự động, việc kiểm tra dữ liệu đến đúng chu kỳ và phát hiện những khoảng thời gian dữ liệu bị gián đoạn là một chỉ báo vận hành quan trọng.
Kiểm tra truyền bù
Sau một khoảng mất mạng, data logger có thể tiếp tục lưu dữ liệu cục bộ rồi truyền lại khi kết nối phục hồi.
Do đó cần phân biệt:
· Mất phép đo thật
· Mất truyền tạm thời nhưng dữ liệu còn nguyên
· Mất cả dữ liệu lẫn đường truyền
Nếu chỉ theo dõi trạng thái online/offline mà không kiểm tra dữ liệu truyền bù, một sự cố mạng ngắn có thể bị hiểu nhầm thành mất dữ liệu quan trắc.
Thiết lập cảnh báo nhiều tầng thay vì chỉ dùng một ngưỡng
Cảnh báo tốt phải cho biết mức độ nghiêm trọng và loại vấn đề, không chỉ phát ra thông báo chung “có lỗi”.
Có thể chia thành ba tầng.
Cảnh báo tức thời
Áp dụng cho sự kiện có độ chắc chắn cao, chẳng hạn:
· Mất nguồn
· Thiết bị báo fault
· Mất kết nối data logger
· Bơm lấy mẫu dừng
· Giá trị vượt dải đo của thiết bị
Những lỗi này thường không cần chờ nhiều chu kỳ mới xác nhận.
Cảnh báo duy trì
Một số bất thường chỉ đáng báo động khi tồn tại đủ lâu.
Ví dụ:
· Dữ liệu không thay đổi trong nhiều chu kỳ
· Độ trễ truyền dữ liệu tăng liên tục
· Một tham số bắt đầu lệch khỏi mẫu hoạt động thông thường
Sử dụng điều kiện thời gian giúp giảm báo động giả do nhiễu tức thời.
Cảnh báo xu hướng
Lớp này phát hiện các sự cố phát triển chậm như:
· Drift
· Tần suất lỗi tăng
· Thời gian mất kết nối ngày càng nhiều
· Số lần phải hiệu chuẩn tăng
· Độ lệch giữa hai cảm biến tăng theo thời gian
Đây là lớp quan trọng đối với bảo trì dự báo vì nó có thể nhận biết thiết bị đang suy giảm trước khi thiết bị hỏng hoàn toàn.
Phân biệt sự cố thiết bị với biến động môi trường thật
Đây là một trong những bước khó nhất của giám sát sự cố hệ thống quan trắc.
Một giá trị bất thường không đồng nghĩa với cảm biến hỏng.
Cần kiểm chứng theo nhiều nguồn.
So sánh với thông số liên quan
Nếu một thay đổi có cơ sở vật lý, thường sẽ có dấu hiệu hỗ trợ từ các biến khác.
Ví dụ, thay đổi lớn của tải lượng phát thải có thể đi cùng thay đổi lưu lượng. Ngược lại, nếu chỉ một cảm biến nhảy giá trị trong khi tất cả điều kiện liên quan giữ nguyên, khả năng xảy ra lỗi đo cần được kiểm tra.
So sánh với trạng thái vận hành
Đối với trạm giám sát tại cơ sở sản xuất, dữ liệu môi trường nên được đối chiếu với:
· Trạng thái dây chuyền
· Thời điểm khởi động hoặc dừng thiết bị
· Lưu lượng
· Tải vận hành
· Sự kiện bảo trì
· Quá trình hiệu chuẩn
Một biến động xuất hiện đúng lúc dây chuyền thay đổi chế độ có ý nghĩa khác với biến động xuất hiện khi quá trình hoàn toàn ổn định.
Kiểm tra bằng thiết bị hoặc phương pháp độc lập
Khi giá trị bất thường có ảnh hưởng lớn đến đánh giá môi trường, cần xác minh bằng phép đo kiểm tra, thiết bị dự phòng hoặc phương pháp tham chiếu phù hợp thay vì tự động gắn nhãn dữ liệu là lỗi.
Nguyên tắc QA của các hệ thống quan trắc liên tục cũng yêu cầu đánh giá chất lượng phép đo dựa trên hiệu chuẩn, kiểm tra độ chính xác và hành động khắc phục chứ không dựa duy nhất vào hình dạng chuỗi dữ liệu.
Quy trình xử lý khi hệ thống phát hiện dấu hiệu sự cố
Khi xuất hiện cảnh báo, nên xử lý theo chuỗi nguyên nhân từ hạ tầng đến phép đo.
Bước 1: Xác định phạm vi lỗi
Kiểm tra lỗi xảy ra với:
· Một thông số
· Một thiết bị
· Toàn bộ trạm
· Nhiều trạm
· Chỉ phần truyền dữ liệu
Nếu nhiều thiết bị lỗi cùng lúc, nên ưu tiên kiểm tra nguồn, mạng và data logger.
Bước 2: Kiểm tra trạng thái thiết bị
Đọc mã lỗi, trạng thái vận hành, thời điểm restart, lịch sử hiệu chuẩn và nhật ký bảo trì.
Bước 3: Kiểm tra dữ liệu tại trạm
Xác định dữ liệu gốc còn được ghi tại data logger hay không.
Nếu có dữ liệu tại trạm nhưng máy chủ không có, tập trung vào đường truyền hoặc hệ thống tiếp nhận.
Bước 4: Kiểm tra chất lượng dữ liệu
Xem xét:
· Khoảng mất dữ liệu
· Flatline
· Spike
· Drift
· Giá trị ngoài dải
· Thời gian không đồng bộ
Bước 5: Đối chiếu với điều kiện thực tế
Kiểm tra vận hành nguồn thải, điều kiện môi trường và những cảm biến liên quan để tránh kết luận nhầm biến động thật là lỗi thiết bị.
Bước 6: Khắc phục và xác nhận lại
Sau sửa chữa, không nên chỉ thấy thiết bị “online” rồi coi sự cố đã kết thúc. Cần xác nhận lại rằng:
· Dữ liệu đã xuất hiện đều
· Trạng thái lỗi đã hết
· Giá trị nằm trong vùng hợp lý
· Kết quả kiểm tra hoặc hiệu chuẩn đạt yêu cầu
· Đường truyền hoạt động bình thường
· Dữ liệu thiếu đã được truyền bù nếu hệ thống hỗ trợ
Bước 7: Lưu lịch sử sự cố
Ghi lại nguyên nhân, thời điểm bắt đầu, thời điểm kết thúc và biện pháp khắc phục để phục vụ phân tích lỗi tái diễn.
Các chỉ số nên dùng để đánh giá sức khỏe hệ thống
Việc giám sát sẽ hiệu quả hơn nếu trạng thái của trạm được lượng hóa thành KPI thay vì chỉ hiển thị online/offline.
Một số chỉ số hữu ích gồm:
|
Chỉ số |
Ý nghĩa giám sát |
|
Data availability |
Tỷ lệ dữ liệu thực tế nhận được so với số bản ghi dự kiến |
|
Valid data rate |
Tỷ lệ dữ liệu đạt điều kiện hợp lệ sau kiểm tra QA |
|
Communication uptime |
Tỷ lệ thời gian đường truyền hoạt động |
|
Data latency |
Độ trễ từ lúc tạo dữ liệu đến lúc máy chủ nhận |
|
Fault frequency |
Số lần xuất hiện lỗi trong một khoảng thời gian |
|
Calibration failure rate |
Tần suất kiểm tra/hiệu chuẩn không đạt |
|
MTTR |
Thời gian trung bình cần để khôi phục sau sự cố |
|
Repeated fault count |
Số lỗi cùng loại tái diễn |
Không nên áp dụng một ngưỡng KPI giống nhau cho mọi loại trạm. Chu kỳ đo, công nghệ cảm biến, yêu cầu pháp lý và mức độ quan trọng của từng thông số có thể khác nhau.
Quan trọng hơn giá trị KPI đơn lẻ là xu hướng của KPI. Một trạm vẫn đạt tỷ lệ dữ liệu cao nhưng số lần mất kết nối tăng dần có thể đang phát triển một sự cố chưa nghiêm trọng.
Mô hình giám sát sự cố nên kết hợp rule-based và phát hiện bất thường
Các lỗi rõ ràng phù hợp với rule-based monitoring.
Ví dụ:
· Device_Status = Fault
· Không có dữ liệu trong N chu kỳ
· Giá trị vượt dải đo
· Heartbeat mất
· Data latency vượt ngưỡng
· Hiệu chuẩn không đạt
Ưu điểm của rule-based là dễ hiểu, dễ truy nguyên và phù hợp với các giới hạn kỹ thuật đã biết.
Tuy nhiên, những sự cố như drift hoặc suy giảm từ từ khó phát hiện bằng một ngưỡng đơn. Khi có đủ lịch sử dữ liệu, có thể bổ sung các phép kiểm tra về:
· Độ lệch so với baseline
· Moving average
· Moving standard deviation
· Tốc độ thay đổi
· Tương quan giữa các cảm biến
· Mẫu vận hành theo giờ hoặc theo chế độ sản xuất
Không nên để thuật toán bất thường tự quyết định dữ liệu “sai”. Nó nên tạo suspect flag để kích hoạt bước xác minh kỹ thuật.
Cách này tránh hai cực đoan: cảnh báo quá nhạy làm người vận hành bỏ qua alarm, hoặc cảnh báo quá chậm khiến lỗi kéo dài trước khi được phát hiện.
Một hệ thống cảnh báo tốt phải chỉ ra được nguyên nhân gần nhất
Giá trị thực tế của giám sát không nằm ở số lượng cảnh báo mà ở khả năng giúp người vận hành xác định nhanh nơi cần kiểm tra.
Thay vì:
“Mất dữ liệu NOx”
logic cảnh báo nên phân tầng được:
Máy phân tích NOx không trả dữ liệu
hoặc
Data logger không nhận dữ liệu NOx
hoặc
Data logger có dữ liệu nhưng máy chủ chưa nhận
Ba tình huống có cùng biểu hiện trên dashboard nhưng cách xử lý hoàn toàn khác nhau.
Vì vậy, kiến trúc giám sát nên lưu dấu trạng thái ở từng điểm của chuỗi:
Thiết bị đo → giao tiếp thiết bị → data logger → bộ nhớ → modem/mạng → máy chủ tiếp nhận → cơ sở dữ liệu → dashboard
Đây là nền tảng để rút ngắn thời gian tìm lỗi và hạn chế thay thiết bị không cần thiết.
Giám sát sự cố hệ thống quan trắc hiệu quả cần nhiều hơn một cảnh báo vượt ngưỡng. Hệ thống phải đồng thời kiểm tra tình trạng thiết bị, tính liên tục và hợp lý của dữ liệu, đường truyền, thời gian, hiệu chuẩn và mối quan hệ giữa các thông số.
Dấu hiệu mạnh nhất của sự cố thường không nằm ở một tín hiệu riêng lẻ mà ở sự không nhất quán giữa các lớp: thiết bị báo bình thường nhưng dữ liệu đứng yên, data logger có dữ liệu nhưng máy chủ không nhận, hoặc giá trị biến động mạnh mà không có thay đổi tương ứng trong điều kiện thực tế.
Khi kết hợp cảnh báo tức thời, cảnh báo duy trì, phân tích xu hướng và quy trình xác minh nhiều nguồn, người vận hành có thể phát hiện lỗi sớm hơn, xác định đúng vị trí sự cố và giảm nguy cơ sử dụng dữ liệu không còn đủ độ tin cậy.
Làm sao nhận biết cảm biến quan trắc bị lỗi?
Không nên dựa vào một giá trị bất thường duy nhất. Cần kiểm tra đồng thời mã trạng thái thiết bị, dữ liệu đứng yên hoặc nhảy bất thường, drift, lịch sử hiệu chuẩn và tương quan với các thông số liên quan. Nếu cần, xác minh bằng thiết bị hoặc phương pháp độc lập.
Mất dữ liệu có đồng nghĩa với thiết bị đo bị hỏng không?
Không. Dữ liệu có thể mất do thiết bị đo, giao tiếp giữa thiết bị với data logger, data logger, mạng truyền dẫn hoặc máy chủ tiếp nhận. Kiểm tra dữ liệu còn lưu tại trạm hay không là bước quan trọng để khoanh vùng nguyên nhân.
Có nên cảnh báo mỗi khi dữ liệu thay đổi đột ngột không?
Không nên. Biến động đột ngột có thể là hiện tượng môi trường thực. Cảnh báo nên kết hợp biên độ thay đổi, thời gian duy trì, trạng thái thiết bị và các thông số liên quan để hạn chế báo động giả.
Chỉ theo dõi trạng thái online/offline có đủ để giám sát sự cố không?
Không. Một thiết bị vẫn có thể online nhưng trả dữ liệu sai, bị drift hoặc đứng giá trị. Vì vậy cần theo dõi cả trạng thái thiết bị, chất lượng dữ liệu, độ trễ truyền, hiệu chuẩn và lịch sử cảnh báo.



GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm

Bài xem nhiều
